KI deckt jahrzehntealte Schwachstellen in Computersystemen auf, verschafft Cybersicherheitsunternehmen bisher unerreichte Analysemöglichkeiten und beschleunigt die Modernisierung bestehender Software. Doch damit stellt sich eine grundlegende Frage: Werden Systeme tatsächlich sicherer, wenn immer mehr Sicherheitslücken entdeckt werden, oder schaffen wir einen zunehmend kostspieligen Kreislauf aus Warnmeldungen, Anpassungen und immer neuen Problemen?
Die 14 Jahre alte Sicherheitslücke, die die Cybersicherheit verändert hat
Im Oktober 2026 zeigte die Entdeckung zweier kritischer Sicherheitslücken in PHP, einer der am häufigsten für Websites eingesetzten Programmiersprachen, wie grundlegend KI die Cybersicherheit verändert. Besonders bemerkenswert war, dass einige der betroffenen Mechanismen bereits 14 Jahre alt waren.
Diese Entdeckung ist bedeutsam, weil sie einen Wandel in der Sicherheitsforschung verdeutlicht. Laut der technischen Analyse von Wiz Research konnten hochentwickelte KI-Modelle den Aufwand, den betroffenen Code zu verstehen und die Schwachstellen auszunutzen, erheblich reduzieren. Nach Angaben der Forscher ließ sich eine Arbeit, für die zuvor möglicherweise ein hoch spezialisiertes Team mehrere Monate benötigt hätte, von einer erfahrenen Fachkraft mithilfe von KI in etwa einer Woche erledigen.
Die Auswirkungen gehen weit über PHP hinaus. Eine Schwachstelle wird nicht allein dadurch gefährlich, dass sie existiert. Entscheidend ist auch, ob sie jemand entdecken und ausnutzen kann.
Genau diesen zweiten Faktor verändert KI.
Kann eine Software, die jahrelang zuverlässig funktioniert hat, plötzlich zu einem realistischen Angriffsziel werden, ohne dass auch nur eine Zeile ihres Codes verändert wurde? Liegt das daran, dass sich nicht unbedingt das System verschlechtert hat, sondern die Fähigkeiten potenzieller Angreifer zugenommen haben?
Dieser Unterschied erklärt, weshalb die zunehmende Entdeckung von Sicherheitslücken nicht einfach als unnötige Panikmache abgetan werden kann. Manche neu entdeckten Schwachstellen verändern das tatsächliche Angriffsrisiko eines Unternehmens. Zugleich stellt sich aber eine wichtige Frage: Wenn KI Probleme aufdecken kann, die jahrzehntelang verborgen geblieben sind, wie viele weitere Schwachstellen werden dann mit immer leistungsfähigeren Analysemethoden ans Licht kommen? Und wie entscheiden wir, welche Erkenntnisse tatsächlich unsere Aufmerksamkeit verdienen?
Warum mehr entdeckte Probleme nicht zwangsläufig mehr Gefahr bedeuten
In der Softwareentwicklung ist die automatisierte Erkennung von Sicherheitslücken nichts Neues. Seit Jahrzehnten werden Werkzeuge zur statischen Codeanalyse eingesetzt, um Quellcodes zu untersuchen, ohne sie auszuführen. Dabei suchen sie nach Programmiermustern, die Sicherheits- oder Zuverlässigkeitsprobleme verursachen können.
Moderne KI-gestützte Systeme erweitern diese Möglichkeiten. Sie helfen dabei, komplexe Zusammenhänge zu analysieren, Ergebnisse einzuordnen, Testfälle zu erstellen und Verhaltensweisen zu untersuchen, die herkömmlichen Verfahren möglicherweise entgangen sind.
Allerdings hat die Forschung längst gezeigt, dass die automatisierte Erkennung auch eigene Probleme mit sich bringt. Johnson, Song, Murphy-Hill und Bowdidge veröffentlichten auf der International Conference on Software Engineering die Studie Why Don’t Software Developers Use Static Analysis Tools to Find Bugs?. Die Forscher befragten 20 Softwareentwickler, um herauszufinden, weshalb automatisierte Analysewerkzeuge nicht häufiger eingesetzt wurden. Obwohl die Befragten die Vorteile der automatisierten Fehlererkennung grundsätzlich anerkannten, gehörten irrelevante Warnmeldungen zu den wichtigsten Hindernissen.
Eine irrelevante Warnmeldung entsteht beispielsweise, wenn ein System einen harmlosen Zustand als Fehler einstuft. Ein Befund kann also technisch korrekt sein, ohne von praktischer Bedeutung zu sein. Ein Scanner erkennt womöglich zutreffend eine veraltete Komponente, eine ineffiziente Funktion oder eine fehlende Konfigurationseinstellung, liefert aber kaum Hinweise darauf, dass daraus eine ernst zu nehmende Sicherheitsbedrohung entsteht.
Die Informatik beschreibt diesen Zusammenhang mit den Begriffen Precision und Recall, die unter anderem beim Information Retrieval, beim maschinellen Lernen und in Klassifikationssystemen verwendet werden. Precision gibt an, welcher Anteil der gemeldeten Ergebnisse tatsächlich relevant ist. Recall beschreibt dagegen, welcher Anteil aller tatsächlich relevanten Fälle vom System erkannt wird. Ein Scanner, der möglichst viele potenzielle Schwachstellen finden soll, kann einen hohen Recall erreichen, produziert dafür aber möglicherweise zahlreiche irrelevante Warnmeldungen. Für umfassende Untersuchungen kann ein solches System durchaus nützlich sein. Es eignet sich jedoch nicht zwangsläufig dafür, zu entscheiden, welche Probleme tatsächlich behoben werden müssen.
Nehmen wir einen hypothetischen Sicherheitsscanner, der auf einer großen Website 200 potenzielle Probleme meldet. Nach einer technischen Überprüfung stellen sich vielleicht nur zwei davon als echte Sicherheitslücken heraus. Der Scanner muss deshalb nicht zwangsläufig versagt haben: Möglicherweise hat er alle fünf wichtigen Probleme erkannt. Dennoch muss das Unternehmen auch die übrigen Meldungen untersuchen, um ihre Bedeutung einschätzen zu können.
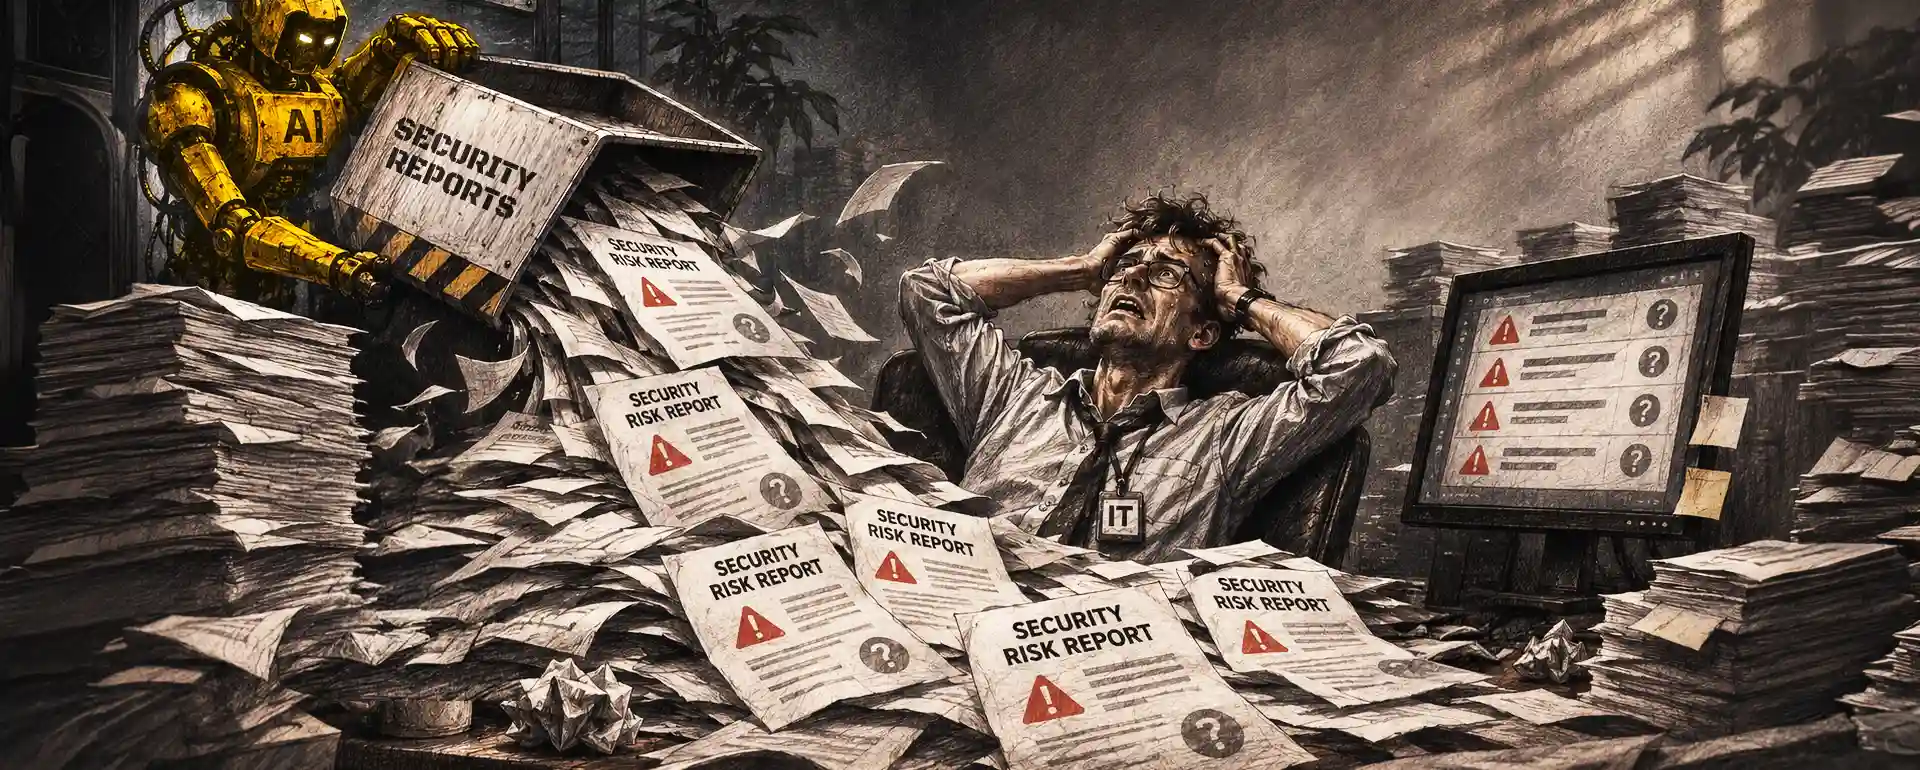
Dieser Unterschied wird umso wichtiger, je schneller und kostengünstiger KI immer anspruchsvollere Analysen ermöglicht. Ein Websitebetreiber erhält möglicherweise einen Bericht mit Hunderten detaillierter technischer Feststellungen. Dadurch entsteht leicht der Eindruck, die Website habe außergewöhnlich viele Sicherheitsprobleme. Ein umfangreicher Bericht kann zwar viele Informationen enthalten, doch seine Länge sagt nichts darüber aus, wie schwerwiegend die festgestellten Probleme tatsächlich sind.
Interessanterweise war selbst die PHP Foundation im Umfeld der PHP-Sicherheitslücken mit diesem Problem konfrontiert. In einer Stellungnahme vom Oktober 2026 berichtete die Organisation, dass ihrem Sicherheitsteam zahlreiche Schwachstellenmeldungen vorlagen, von denen sich mehr als 100 als ungültig, doppelt eingereicht oder nicht reproduzierbar erwiesen. KI-gestützte Forschung führte also einerseits zu echten Entdeckungen, erzeugte andererseits aber auch eine große Menge irrelevanter Meldungen.
Die wissenschaftliche Erkenntnis daraus lautet: Etwas zu erkennen und seine Bedeutung zu beurteilen, sind zwei unterschiedliche Aufgaben. Ein Analysesystem kann große Informationsmengen erzeugen. Um herauszufinden, welche Ergebnisse wirklich wichtig sind, braucht es jedoch Kontext, Überprüfung und fachliches Urteilsvermögen.
Welche Sicherheitslücken tatsächlich relevant sind
Eine der wichtigsten Studien zu diesem Thema stammt von den Cybersicherheitsforschern Allodi und Massacci. In ihrer wissenschaftlich begutachteten Arbeit Comparing Vulnerability Severity and Exploits Using Case-Control Studies untersuchten sie, ob die etablierten Einstufungen des Schweregrads von Sicherheitslücken tatsächlich mit den in der Praxis beobachteten Angriffen übereinstimmen. Sie gingen also nicht einfach davon aus, dass technisch schwerwiegende Schwachstellen automatisch auch am häufigsten ausgenutzt werden.
Besonders interessant ist ihre Methodik, denn sie stammt ursprünglich aus der Epidemiologie. Dieser Wissenschaftszweig untersucht, wie Krankheiten und die damit verbundenen Risikofaktoren in Bevölkerungsgruppen auftreten. Allodi und Massacci übertrugen diesen Ansatz auf die Cybersicherheit, indem sie Schwachstellen, die bei tatsächlichen Angriffen ausgenutzt worden waren, mit solchen verglichen, für die keine Ausnutzung beobachtet worden war.
Die Studie verdeutlichte einen entscheidenden Punkt: Der technische Schweregrad einer Sicherheitslücke und die Wahrscheinlichkeit, dass Angreifer sie tatsächlich ausnutzen, sind zwei unterschiedliche Messgrößen.
Weitere Forschungen bestätigten die Bedeutung dieser Unterscheidung. Im Jahr 2020 veröffentlichten Jacobs, Romanosky, Adjerid und Baker im Journal of Cybersecurity die Studie Improving Vulnerability Remediation Through Better Exploit Prediction. Die Forscher analysierten rund 76.000 öffentlich bekannt gewordene Sicherheitslücken. In den ihnen verfügbaren Datensätzen fanden sie für lediglich etwa 5% Hinweise darauf, dass diese Schwachstellen bei realen Angriffen ausgenutzt worden waren. Das verdeutlicht den erheblichen Unterschied zwischen der Zahl veröffentlichter Sicherheitslücken und der Zahl tatsächlich beobachteter Angriffe.
Das Forum of Incident Response and Security Teams (FIRST) weist ausdrücklich darauf hin, dass eine solche Wahrscheinlichkeit allein noch kein vollständiges Maß für das Sicherheitsrisiko eines Unternehmens darstellt. Sie berücksichtigt weder die möglichen Folgen eines Angriffs noch die konkreten Bedingungen des betroffenen Systems.
Eine ähnliche Unterscheidung findet sich im Katalog Known Exploited Vulnerabilities der US-amerikanischen Cybersecurity and Infrastructure Security Agency (CISA). Deren risikobasierte Vorgaben aus dem Jahr 2026 betonen, dass besonders gefährliche Schwachstellen priorisiert werden müssen, anstatt jede Sicherheitslücke gleich zu behandeln.
Diese Ansätze liefern eine anerkannte wissenschaftliche Grundlage für ein Prinzip, das im KI-Zeitalter immer wichtiger wird: Die Zahl der gefundenen Sicherheitslücken ist kein zuverlässiger Maßstab dafür, wie unsicher ein System tatsächlich ist. Sicherheitsentscheidungen müssen berücksichtigen, wie wahrscheinlich eine Ausnutzung ist, welche Folgen ein Angriff hätte, wie stark das System potenziellen Angriffen ausgesetzt ist und welche Schutzmaßnahmen bereits bestehen.
Ein wachsendes Geschäftsmodell rund um Sicherheitswarnungen
Die Identifizierung potenzieller Sicherheitslücken wird zunehmend zu einer leicht zugänglichen kommerziellen Dienstleistung. Etablierte Cybersicherheitsunternehmen führen seit Langem Schwachstellenanalysen und Penetrationstests durch. KI-gestützte Werkzeuge können jedoch den Zeitaufwand für erste Untersuchungen, die Klassifizierung von Ergebnissen und die Erstellung von Berichten deutlich reduzieren. Für Anbieter von Website-Wartung oder Sicherheitsdienstleistungen eröffnet das die Möglichkeit, Unternehmen gezielt auf technische Auffälligkeiten ihrer bestehenden Websites anzusprechen.
Ein unaufgefordert versandtes Sicherheitsschreiben, das ich für diesen Artikel bei einem unserer Kunden untersucht habe, veranschaulicht die Vorgehensweise. Der Absender informierte den Betreiber der Website darüber, dass öffentlich zugängliche Informationen auf mehrere fehlende Sicherheitsmaßnahmen hindeuteten, darunter bestimmte HTTP-Sicherheitsheader. Das Schreiben verwies auf aktuelle PHP-Sicherheitslücken, betonte die möglichen Folgen von Cyberangriffen und bot professionelle Unterstützung an. Die Warnungen waren so beunruhigend, dass unser Kunde uns um eine Einschätzung bat.
Die Hinweise waren nicht vollständig unbegründet. Tatsächlich wurden mehrere Schwächen bei HTTP-Sicherheitsheadern festgestellt, wie sie auf vielen Websites vorkommen. Dabei handelt es sich grundsätzlich um sinnvolle Schutzmechanismen. Das verlieh dem Schreiben technische Glaubwürdigkeit, sodass es nicht einfach als offensichtlicher Versuch erschien, unnötige Dienstleistungen zu verkaufen. Allerdings zeigen auch die Empfehlungen von OWASP, dass solche Befunde fachlich eingeordnet werden müssen. Nicht jeder fehlende Sicherheitsheader stellt eine relevante Sicherheitslücke dar oder muss überhaupt ergänzt werden. Genau diese Unterscheidung fehlte in dem unaufgefordert versandten Schreiben. Statt die tatsächlichen Sicherheitsrisiken zu bewerten, präsentierte das Unternehmen seine Ergebnisse und bot an, die vermeintlichen Probleme gegen Bezahlung zu beheben.
Das verdeutlicht den wichtigen Unterschied zwischen dem Abarbeiten einer Checkliste und einer echten Sicherheitsbewertung. Ein Scanner kann korrekt feststellen, dass ein bestimmter Header fehlt. Daraus folgt jedoch nicht automatisch, dass eine praktisch ausnutzbare Sicherheitslücke besteht. Ebenso wenig verbessert das wahllose Hinzufügen sämtlicher denkbarer Sicherheitsheader zwangsläufig die Sicherheit. Falsche Konfigurationen können sogar die Funktionalität einer Website beeinträchtigen, etwa bei eingebundenen Diensten und Anwendungen von Drittanbietern.
Mit den wirtschaftlichen Folgen der Behebung von Sicherheitslücken beschäftigt sich die Forschung bereits seit Jahren. Der Microsoft-Forscher Herley veröffentlichte dazu die Arbeit So Long, And No Thanks for the Externalities: The Rational Rejection of Security Advice by Users. Er untersuchte, weshalb Menschen Empfehlungen zur Cybersicherheit häufig ignorieren, und argumentierte, dass dies wirtschaftlich durchaus rational sein kann, wenn der Zeit- und Arbeitsaufwand für die Umsetzung größer ist als der zu erwartende Nutzen.
Stellen wir uns ein Unternehmen vor, das jeden Monat 10 Sicherheitsanalysen erhält, die jeweils unterschiedliche potenzielle Schwachstellen auflisten. Selbst wenn alle Anbieter in guter Absicht handeln, muss das Unternehmen Ressourcen aufwenden, um die Ergebnisse zu überprüfen, bereits vorhandene Schutzmaßnahmen zu berücksichtigen und zu entscheiden, ob weitere Arbeiten gerechtfertigt sind.
Daraus ist faktisch ein Geschäftsmodell geworden: Anbieter lassen Websites mithilfe KI-gestützter Systeme automatisch untersuchen, erstellen zu minimalen Kosten Sicherheitsberichte und verschicken unaufgefordert Briefe und E-Mails an Websitebetreiber, um neue Kunden zu gewinnen. Die Empfänger tragen dagegen die erheblich höheren Kosten für die Überprüfung der Befunde und gegebenenfalls für die Umsetzung notwendiger Korrekturen.
Wir beobachten zunehmend, wie sich dieses Geschäftsmodell in der Praxis ausbreitet. Immer mehr unserer Kunden erhalten KI-gestützte Sicherheitsberichte mit entsprechenden Handlungsempfehlungen. Inzwischen meldet sich fast täglich mindestens ein Kunde bei uns, nachdem ein solches Schreiben eingegangen ist, und fragt, wie mit den angeblichen Problemen umzugehen sei. Diese Warnungen sorgen bei unseren Kunden für erhebliche Verunsicherung. Die versendenden Unternehmen erzeugen ein Gefühl der Dringlichkeit, ohne überhaupt nachzuweisen, wie schwerwiegend die festgestellten Risiken tatsächlich sind.
Ein kommerzieller Anbieter profitiert davon, zusätzliche Probleme zu entdecken und Dienstleistungen zu deren Behebung anzubieten. Das Unternehmen, das die Warnung erhält, muss dagegen selbst entscheiden, ob die Ausgaben überhaupt einen nennenswerten Sicherheitsgewinn bringen.
Security Fatigue: Wenn Sicherheitswarnungen zur Dauerbelastung werden
2016 veröffentlichten die Forscher Stanton, Theofanos, Spickard Prettyman und Furman im Umfeld des US-amerikanischen National Institute of Standards and Technology (NIST) die Studie Security Fatigue. In halbstrukturierten Interviews mit 40 Personen untersuchten sie, wie Menschen Sicherheitsanforderungen im Internet wahrnehmen und damit umgehen. Mehr als die Hälfte berichtete von sich aus über Erfahrungen, die auf eine solche Sicherheitsmüdigkeit hindeuteten.
Die Forscher beobachteten unter anderem Resignation, das Gefühl eines Kontrollverlusts, die Verharmlosung von Risiken und das Vermeiden sicherheitsbezogener Entscheidungen. Ihre Ergebnisse lieferten Hinweise darauf, dass übermäßige Sicherheitsanforderungen beeinflussen können, wie Menschen Sicherheitshinweise bewerten und darauf reagieren.
Für KI-generierte Schwachstellenberichte ist diese Erkenntnis besonders relevant. Wenn Websitebetreiber immer wieder Warnungen vor unterschiedlichsten technischen Problemen erhalten, besteht die Gefahr, dass sie irgendwann sämtliche Sicherheitsmeldungen nur noch als gewöhnliche Verkaufsversuche betrachten. Dadurch könnten auch Warnungen weniger Beachtung finden, bei denen tatsächlich dringender Handlungsbedarf besteht.
Für Unternehmen, die unaufgeforderte Sicherheitsanalysen erhalten, ergibt sich daraus eine wichtige Unterscheidung: Es ist etwas anderes, nachzuweisen, dass eine Schwachstelle existiert, als zu belegen, dass eine angebotene Dienstleistung das Risiko tatsächlich verringert. Eine fundierte Empfehlung sollte erklären, wie die Schwachstelle ausgenutzt werden könnte, welche Folgen das hätte und welchen nachweisbaren Nutzen ihre Behebung verspricht.
Andernfalls wird aus einer Sicherheitsempfehlung ein kommerziell überzeugendes Angebot, dessen tatsächlicher Wert sich nur schwer und mit erheblichem Aufwand beurteilen lässt.
Wenn Hosting-Probleme zu Vorwürfen gegen die Website-Entwicklung werden
Hier zeigt sich ein weiteres Problem. Zunächst muss man verstehen, dass KI-gestützte Softwareentwicklung die Modernisierung bestehender Anwendungen zwar erleichtert, Änderungen an etablierten Systemen jedoch Risiken mit sich bringen. Wie die Lehman’schen Gesetze der Softwareevolution und Hyrum’s Law beschreiben, entstehen in Software im Laufe der Zeit zunehmende Komplexität und verborgene Abhängigkeiten. Manche Systeme verlassen sich dabei auf Verhaltensweisen, die selbst den für die Entwicklung Verantwortlichen möglicherweise nicht bewusst sind.
Besonders relevant wird das, wenn Hosting-Anbieter PHP-Versionen, Datenbanken, Caching-Systeme oder Serverkonfigurationen aktualisieren. Selbst Änderungen, die eigentlich Sicherheit und Leistung verbessern sollen, können Anwendungen beeinträchtigen, die zuvor zuverlässig funktioniert haben.
Auch Googles 2025 DORA State of AI-Assisted Software Development Report stellte einen negativen Zusammenhang zwischen der Einführung von KI und der Stabilität von Software fest.
Bei einem meiner Kunden mit einer mittelgroßen Website kam es plötzlich zu wiederholten Ausfällen. Wichtige Funktionen waren zeitweise für mehrere Minuten nicht erreichbar. Die Probleme traten praktisch von einer Woche auf die andere auf, obwohl die Website zuvor ohne Probleme funktioniert hatte.
Der Kunde wandte sich an seinen Hosting-Anbieter. Dieser untersuchte die Serverprotokolle und stellte fest, dass bestimmte Komponenten der Website zeitweise mehrere Minuten lang nicht mehr reagierten. Zusätzlich identifizierte der Anbieter zahlreiche weitere Probleme mit Plugins, Theme-Komponenten und anderen Bereichen der Website.
Meine Aufmerksamkeit erregte vor allem der außergewöhnliche Detailgrad des technischen Berichts, den mir der Kunde weiterleitete. Die darin aufgeführten Erkenntnisse hätten bei einer manuellen Untersuchung normalerweise mehrere Wochen Arbeit durch eine erfahrene Fachkraft für IT-Sicherheit erfordert. Dass der Hosting-Anbieter diesen Aufwand tatsächlich für eine gewöhnliche Supportanfrage betrieben hatte, hielt ich für äußerst unwahrscheinlich. Ich kam deshalb zu dem Schluss, dass der Bericht mithilfe eines KI-gestützten Scanwerkzeugs erstellt worden war.
Aus betrieblicher Sicht wäre das durchaus nachvollziehbar. Hosting-Anbieter bearbeiten große Mengen an Supportanfragen. Mit KI-Werkzeugen können ihre technischen Abteilungen inzwischen umfangreiche automatisierte Prüfungen durchführen und detaillierte Berichte erstellen, ohne für jedes einzelne Supportticket erhebliche Entwicklungsressourcen aufwenden zu müssen.
Die festgestellten Probleme waren technisch relevant, betrafen jedoch unterschiedliche Bereiche der Website. In der Korrespondenz wurden diese zusätzlichen Mängel getrennt von den eigentlichen Ausfällen beschrieben. Ein Nachweis dafür, dass sie tatsächlich die Ursache für die zeitweise Nichterreichbarkeit der Website waren, wurde nicht erbracht.
Genau diese Unterscheidung ist bei der Root Cause Analysis, also der systematischen Ursachenanalyse, von zentraler Bedeutung. Sie ist ein etabliertes Verfahren zur Untersuchung von Störungen in technischen und informationstechnischen Systemen. Wird bei einer Untersuchung ein Fehler entdeckt, bedeutet das noch lange nicht, dass dieser Fehler auch den konkreten Ausfall verursacht hat. Um einen ursächlichen Zusammenhang nachzuweisen, muss ein plausibler Mechanismus durch Belege gestützt werden, idealerweise durch eine zeitliche Zuordnung, die Reproduzierbarkeit des Fehlers und die Analyse des relevanten Systemverhaltens.
Wenn eine Website beispielsweise seit Jahren PHP-Warnmeldungen erzeugt, aber erst seit Kurzem Timeouts auftreten, können diese Warnmeldungen allein die Veränderung nicht erklären. Es müsste untersucht werden, ob die Warnungen zugenommen haben, ob sie mit einer Überlastung der Systemressourcen zusammenhängen, ob der betreffende Code verändert wurde oder ob sich die Betriebsbedingungen beim Hosting-Anbieter geändert haben.
Googles Organisation für Site Reliability Engineering hat für genau solche Fragestellungen umfangreiche Verfahren entwickelt. In den Empfehlungen zur Postmortem-Kultur betont Google die Bedeutung einer faktenbasierten Untersuchung von Störungen. Dabei sollen die beitragenden Umstände ermittelt werden, anstatt vorschnell Schuld zuzuweisen. Untersucht wird, was geschehen ist, warum sich das System auf eine bestimmte Weise verhalten hat und welche Änderungen eine Wiederholung verhindern könnten.
Eine aussagekräftige Untersuchung erfordert deshalb mehr als eine Liste von Unzulänglichkeiten im Programmcode. Dazu können beispielsweise der Vergleich von Serverkonfigurationen vor und nach dem Vorfall, die Untersuchung bisheriger Softwarebereitstellungen, die Analyse des Ressourcenverbrauchs einzelner Prozesse, die Nachverfolgung bestimmter Anfragen und Tests zur Reproduzierbarkeit vermuteter Fehler gehören.
Besonders wichtig ist das, wenn sich Hosting-Anbieter und Anwendungsentwicklung die Verantwortung für den Betrieb teilen. Während die Anwendungsseite beispielsweise den Programmcode, Plugins und Datenbankabfragen kontrolliert, liegt die Verantwortung für Serverinfrastruktur, Ressourcenzuweisung und wichtige Laufzeitkonfigurationen beim Hosting-Anbieter. Ein Fehler kann auf beiden Seiten oder durch das Zusammenspiel beider Umgebungen entstehen.
KI-gestützte Diagnosewerkzeuge können helfen, solche Zusammenhänge zu untersuchen. Sie ersetzen aber nicht den Nachweis der tatsächlichen Ursache. Ein besonders detaillierter technischer Bericht ist nicht automatisch eine Ursachenanalyse. Und allein die Entdeckung zahlreicher Fehler beweist noch nicht, wer für einen Ausfall verantwortlich ist.
Das dahinterstehende Prinzip ist einfach, aber entscheidend: Bei der Untersuchung einer Störung geht es nicht darum, alles aufzuspüren, was sich theoretisch verbessern ließe. Es geht darum herauszufinden, warum ein bestimmter Fehler aufgetreten ist und durch welche Maßnahme er sich künftig verhindern lässt.
Wenn KI Sicherheitslücken schneller entdeckt, als Menschen sie beheben können
Das wachsende Ungleichgewicht zwischen der Entdeckung von Sicherheitslücken und ihrer Behebung stellt die Verantwortlichen für Softwarewartung bereits vor erhebliche Probleme. Ein besonders anschauliches Beispiel ist curl, ein weitverbreitetes Open-Source-Projekt zur Datenübertragung zwischen Computern über Netzwerke.
Im Januar 2026 kündigte Daniel Stenberg, der leitende Entwickler von curl, die Einstellung des vergüteten Bug-Bounty-Programms für Sicherheitslücken an. Grund war die wachsende Zahl qualitativ minderwertiger Sicherheitsberichte, die das Wartungsteam erheblich belastete. Automatisierte und KI-gestützte Einsendungen machten es leicht, plausibel wirkende Berichte zu erstellen. Für die Überprüfung ihrer Richtigkeit war jedoch weiterhin spezialisiertes technisches Fachwissen erforderlich.
Bis Oktober 2026 hatte sich das Problem weiterentwickelt. In seinem Artikel Ignore the Slop erklärte Stenberg, dass er inzwischen zunehmend technisch korrekte Berichte erhielt, die tatsächliche Fehler aufzeigten.
Diese Entwicklung ist besonders bedeutsam, denn damit entfällt eine naheliegende Erklärung für die steigende Arbeitsbelastung: Es geht nicht mehr nur um eine große Zahl wertloser Meldungen. Auch tatsächlich vorhandene Schwachstellen verursachen erheblichen Aufwand. Jemand muss ihre Auswirkungen auf die Sicherheit bewerten, geeignete Korrekturen entwickeln, die Änderungen testen und aktualisierte Software bereitstellen.
Die Cloud Security Alliance untersuchte diese Entwicklung in ihrer Forschungsnotiz vom 7. Oktober 2026 mit dem Titel When Discovery Outruns Remediation: Open-Source Disclosure Strain. Die Organisation unterschied zwischen einer übermäßigen Zahl ungültiger Meldungen und einem möglicherweise noch gravierenderen Problem: Die Zahl echter Entdeckungen wächst schneller als die verfügbaren technischen Ressourcen für deren Behebung.
Das zugrunde liegende Ungleichgewicht ist offensichtlich. Eine potenzielle Sicherheitslücke aufzuspüren ist nicht dasselbe, wie eine sichere Korrektur dafür zu entwickeln. KI kann zwar bei einzelnen Arbeitsschritten helfen, doch die technischen und betrieblichen Folgen von Softwareänderungen müssen weiterhin beurteilt werden. Je schneller neue Schwachstellen entdeckt werden, desto eher könnte die Fähigkeit, zuverlässige Korrekturen umzusetzen, zum eigentlichen Engpass werden und nicht mehr die Fähigkeit, zusätzliche Probleme zu finden.
Kann es jemals vollkommene Sicherheit geben?
Die Vorstellung, sämtliche Sicherheitslücken aus einem Computersystem entfernen zu können, widerspricht dem grundlegenden Ansatz des modernen Risikomanagements in der Cybersicherheit. Sicherheitsstandards gehen im Allgemeinen davon aus, dass Unternehmen dauerhaft Risiken ausgesetzt sind, von denen sich manche niemals vollständig beseitigen lassen.
Das US-amerikanische National Institute of Standards and Technology beschreibt diesen Ansatz in der Special Publication 800-30, Guide for Conducting Risk Assessments. Das Regelwerk betont, wie wichtig es ist, Bedrohungen, Schwachstellen, Eintrittswahrscheinlichkeiten, mögliche Auswirkungen und Unsicherheiten zu verstehen, um angemessene Gegenmaßnahmen auswählen zu können. Es verlangt nicht, jede denkbare Schwachstelle als Notfall zu behandeln.
Ein weiteres Beispiel ist das Prinzip der Defense in Depth, der mehrschichtigen Absicherung. Anstatt davon auszugehen, dass sich jede Softwarekomponente vollkommen absichern lässt, setzen Unternehmen mehrere Schutzmaßnahmen ein, um die Folgen einzelner Schwachstellen zu begrenzen. Selbst wenn eine Anwendung eine bisher unentdeckte Sicherheitslücke enthält, können Netzwerkbeschränkungen, Zugriffskontrollen, Überwachung und geeignete Berechtigungen die Wahrscheinlichkeit oder die Auswirkungen eines Angriffs reduzieren.
KI produziert immer mehr Erkenntnisse. Die eigentliche Schwierigkeit besteht darin, zu entscheiden, welche Verbesserungen ihre Kosten rechtfertigen und welche Änderungen möglicherweise größere Risiken verursachen als die Schwachstellen, die sie beseitigen sollen.
Das Sisyphus-Problem: Wenn Sicherheit zur endlosen Aufgabe wird
Die Parallele zur Geschichte von Sisyphus liegt auf der Hand: Software wird mit immer leistungsfähigeren KI-Systemen fortlaufend untersucht, entdeckte Schwachstellen werden behoben, und sobald neue Werkzeuge weitere Probleme finden, beginnt der gesamte Prozess von vorn.
Softwarewartung war schon immer eine dauerhafte Aufgabe. Neue Sicherheitslücken werden entdeckt, Abhängigkeiten entwickeln sich weiter und Betriebsumgebungen verändern sich. Dass Wartungsarbeiten niemals endgültig abgeschlossen sind, bedeutet nicht, dass sie überflüssig wären. Entscheidend ist vielmehr die Frage, ob die zunehmende Menge KI-generierter Befunde zu einer entsprechenden Verbesserung der Sicherheit führt oder lediglich den Arbeitsaufwand erhöht, den Unternehmen bewältigen sollen.
Dabei kann auch ein Rückkopplungseffekt entstehen. Ein Unternehmen erhält einen automatisierten Bericht über Schwachstellen in seiner Anwendung und beauftragt deren Behebung. Die Änderungen beseitigen zwar die gemeldeten Probleme, beeinflussen aber das Verhalten anderer Komponenten. Weitere Tests decken Kompatibilitätsprobleme auf, die zusätzliche Anpassungen erforderlich machen. Bei einer späteren Prüfung werden neuere Standards zugrunde gelegt, wodurch weitere Mängel sichtbar werden. Die Anwendung kann im Verlauf dieses Prozesses sicherer werden. Gleichzeitig entstehen jedoch fortlaufende Kosten und wiederkehrende betriebliche Risiken.
Die Zukunft der Cybersicherheit könnte davon abhängen, zu wissen, was man nicht beheben muss
Die vielleicht wichtigste Folge der KI-gestützten Erkennung von Sicherheitslücken ist eine Veränderung der Fachkompetenzen, die Unternehmen benötigen. Wenn es vergleichsweise günstig wird, potenzielle Schwachstellen aufzuspüren, bemisst sich der Wert professioneller Sicherheitsarbeit zunehmend daran, wie zuverlässig Befunde überprüft, ihre Auswirkungen verstanden und geeignete Gegenmaßnahmen ausgewählt werden.
Für Hosting-Anbieter gilt das gleiche Prinzip bei der Diagnose von Störungen. Eine umfassende Liste von Mängeln einer Anwendung kann hilfreich sein, ersetzt aber keine nachvollziehbare Erklärung für die Ursache eines Ausfalls. In der Softwareentwicklung setzt eine erfolgreiche Fehlerbehebung voraus, dass die Wechselwirkungen einer geplanten Änderung mit dem bestehenden System verstanden werden. Für Unternehmen ist nicht entscheidend, wie viele Schwachstellen ein Dienstleister entdecken kann, sondern welche davon eine Investition rechtfertigen und welchen messbaren Nutzen die vorgeschlagenen Maßnahmen erwarten lassen.
Diese Unterscheidung ist auch für die kommerzielle Cybersicherheitsbranche wichtig. KI-gestützte Scans können effiziente und wertvolle Sicherheitsdienstleistungen ermöglichen. Die Fähigkeit, detaillierte Warnungen zu erstellen, darf jedoch nicht mit der Fähigkeit verwechselt werden, Risiken zuverlässig zu bewerten. Ein Anbieter, der eine einzige tatsächlich gefährliche Sicherheitslücke erkennt und eine zuverlässige Lösung dafür bietet, kann einen erheblich größeren Nutzen schaffen als ein Anbieter, der Dutzende technisch korrekter, aber für den Betrieb bedeutungsloser Befunde auflistet.
Mehr Sicherheitslücken bedeuten nicht automatisch weniger Sicherheit
KI hat bereits eindrucksvoll gezeigt, dass sie selbst in seit Langem etablierter Software schwerwiegende Schwachstellen aufdecken kann.
Gleichzeitig zeigen Jahrzehnte wissenschaftlicher Forschung in Informatik, Cybersicherheit, Softwareentwicklung und Sicherheitsökonomie, dass das Erkennen technischer Schwächen und die tatsächliche Verbesserung der Sicherheit zwei unterschiedliche Ziele sind. Automatisierte Werkzeuge können Ergebnisse mit geringem praktischem Nutzen produzieren. Die technische Einstufung des Schweregrads allein sagt nicht zuverlässig voraus, ob eine Schwachstelle ausgenutzt wird. Zu viele Warnungen können dazu führen, dass wichtige Bedrohungen übersehen werden. Und Änderungen an Software können neue Betriebsstörungen verursachen, wenn ihre Folgen nicht ausreichend verstanden werden.
Die zunehmende Verfügbarkeit KI-gestützter Sicherheitsanalysen fügt diesen bekannten Problemen eine kommerzielle Dimension hinzu. Unternehmen können potenzielle Schwachstellen zu geringeren Kosten identifizieren und damit auf mögliche Neukunden zugehen. Die Empfänger müssen dagegen entscheiden, ob die Befunde den Aufwand für eine Behebung tatsächlich rechtfertigen.
Die zentrale Frage lautet daher nicht, ob KI weiterhin Sicherheitslücken entdecken wird. Die bisherigen Erkenntnisse sprechen eindeutig dafür. Viel wichtiger ist die Frage, ob Unternehmen ebenso wirksame Methoden entwickeln werden, um diese Entdeckungen zu bewerten, tatsächliche Sicherheitsrisiken von weniger bedeutenden technischen Unzulänglichkeiten zu unterscheiden und Korrekturen vorzunehmen, ohne die Zuverlässigkeit ihrer Systeme unnötig zu gefährden.
Das Internet war noch nie frei von Sicherheitslücken. Ebenso wenig gibt es eine wissenschaftliche Grundlage für die Annahme, dass komplexe Softwaresysteme irgendwann vollkommen fehlerfrei sein werden. Kontinuierliche Verbesserungen bleiben notwendig. Doch ständige Veränderungen sind nicht automatisch gleichbedeutend mit Verbesserungen.